Hay un experimento en Agentic Engineering que explica, mejor que cualquier argumento, por qué los proyectos de datos salen mal.
Un amigo de Addy Osmani, escéptico de los agentes de IA, le pasó a uno un párrafo describiendo un endpoint de reportes. En doce minutos tuvo un pull request que compilaba, corría y pasaba sus tests. Se entusiasmó, y entonces hizo lo obvio: corrió el mismo párrafo en cinco agentes en paralelo y se fue a hacer un café.
Los cinco volvieron con código que compilaba y funcionaba, y que parecía escrito por un ingeniero competente. Pero ninguno resolvía el mismo problema. Uno usó otro modelo de autenticación. Otro cambió en silencio la forma de la respuesta. Otro escribió en una base de datos distinta. Otro era correcto pero con una interfaz de consulta inútil. El último inventó media especificación copiando una funcionalidad parecida del repositorio, y tuvo suerte.
La conclusión de Osmani es la frase que hay que llevarse:
No corrió una spec cinco veces. Corrió cinco specs distintas. Él había escrito una sola; las otras cuatro las completaron los agentes.
Si alguna vez pediste "extraeme los datos de este sitio" y recibiste algo que técnicamente cumplía y no servía, acabás de leer la explicación.
La vaguedad se ramifica (y casi nunca parece vaga)
El principio central del capítulo: cada ambigüedad que dejás en una especificación se resuelve sin vos, una vez por cada agente o persona que la lee.
Y el problema es que la vaguedad no se ve vaga. "Los datos del catálogo" suena a requisito. "Los precios actualizados" suena a requisito. "Que esté limpio" suena a requisito. Ninguno decide nada:
| Lo que parece un requisito | La decisión que esconde |
|---|---|
| "los datos del catálogo" | ¿Todo el catálogo o solo lo disponible? ¿Las variantes son filas separadas? |
| "precios actualizados" | ¿Cada cuánto? ¿Precio de lista, con descuento, o financiado? ¿Con o sin impuestos? |
| "que esté limpio" | ¿Qué hago con un registro al que le falta el SKU: lo descarto o lo entrego con nulo? |
| "los productos de la competencia" | ¿Qué sitios, exactamente? ¿Qué pasa si uno cambia de estructura a mitad del mes? |
| "que sea rápido" | Sin número, cualquier número cumple |
Cada una de esas frases es, en palabras de Osmani, una bifurcación sin cartel. El agente —o el proveedor, o el equipo interno— elige un camino con total seguridad y sin avisarte que la bifurcación existía.
Lo contraintuitivo es lo que sigue: cuanto más rápido ejecutan los agentes, más importa la especificación. Antes, la ambigüedad estaba acotada por la velocidad de tipeo. Ahora podés dejar cien decisiones implícitas y tenerlas todas resueltas, de forma plausible y equivocada, antes de que se enfríe el café.
Dex Horthy tiene una aritmética que vale la pena memorizar:
- una mala línea de código es una mala línea de código;
- una mala línea de plan puede generar cientos de líneas malas;
- una mala línea de investigación —entender mal dónde está algo— puede generar miles.
La atención rinde más arriba de la cadena que en el diff de dos mil líneas del final.
Las siete partes de la spec
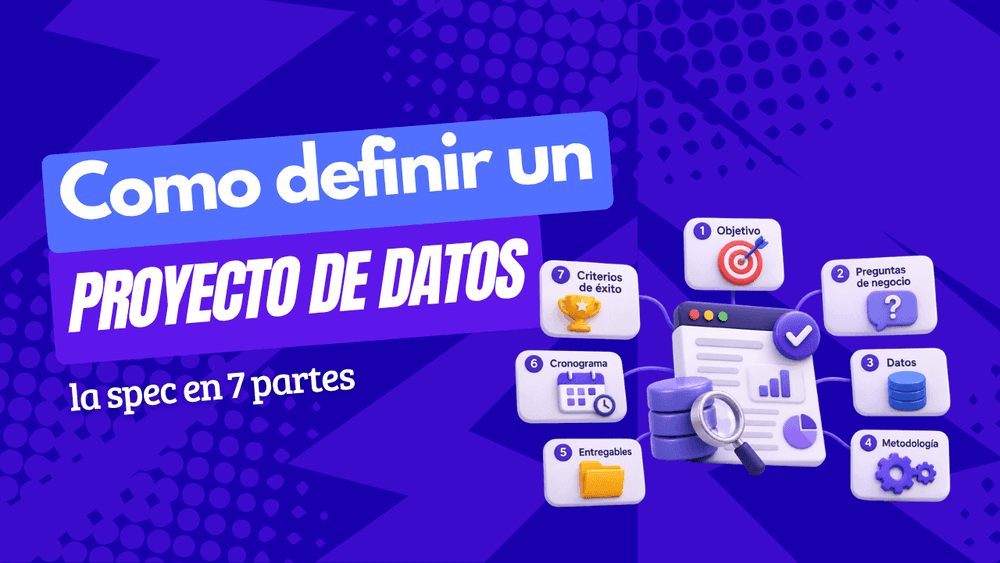
Osmani propone siete categorías. Las especificaciones chicas usan dos o tres; las grandes, las siete. Acá van traducidas a un proyecto de datos web.
1. Objetivo
Un párrafo, en lenguaje llano: qué y para qué. No "extraer precios de tres sitios", sino "precios y stock diarios de tres competidores para que el equipo comercial ajuste su pricing semanal".
La prueba: si no lo podés decir en tres frases, todavía no entendés el objetivo. Y tiene una segunda función muy concreta: cuando hay dos formas razonables de implementar algo, el objetivo es el que desempata.
2. Criterios de aceptación
Condiciones chequeables mirando el resultado. "Datos de buena calidad" no se chequea. Esto sí:
- al menos el 98% de los productos del catálogo objetivo;
- campos obligatorios (SKU, precio, moneda, stock, URL, timestamp) con menos del 1% de nulos;
- entrega disponible antes de las 7:00 hora local.
Osmani es tajante en que escatimar acá es la causa más común de un trabajo que cumple la especificación y que los humanos igual rechazan.
3. Casos borde e invariantes
Lo que tiene que seguir siendo cierto, se implemente como se implemente:
- el esquema de salida no cambia sin una versión nueva;
- nunca se superan los límites de frecuencia de requests acordados por dominio;
- no se recolectan datos personales;
- no se usan cuentas reales para loguearse.
La observación del libro es buena: antes estos casos los atrapaba en la revisión un senior que ya se había quemado. Tu agente todavía no se quemó.
4. Límites de integración
Qué entra y qué queda explícitamente afuera. "Cambios solo en el módulo de este sitio; no tocar el módulo común de proxies."
Y la parte que casi nadie escribe, que es la más valiosa: la vía de escape. Qué hace el agente cuando choca con la pared. La respuesta correcta suele ser "frená y decilo", no "resolvelo como puedas". Sin eso, un agente reescribe la capa de autenticación mientras otro agrega un campo, y los dos pasan los tests.
5. Definición de terminado
El estado en el que aceptás la entrega, incluido el proceso. Acá va la distinción más útil del capítulo: aceptación dice que cumple los requisitos; terminado es lo que lo hace entregable.
Para un flujo de datos: tests contra fixtures en verde, validación de esquema limpia, una muestra de 50 filas adjunta, una corrida completa en el entorno de pruebas con los conteos antes y después.
6. Notas y antecedentes
Lo que te diría alguien con experiencia en un café: "este sitio carga los precios por una llamada asíncrona, la API está en tal endpoint"; "probamos una herramienta de automatización de navegador y se bloqueaba, usá esta otra con modo discreto"; "este sitio cambia los identificadores en cada despliegue, usá selectores por texto".
Osmani dice que la diferencia entre converger en una corrida o en tres casi siempre está en esta sección. Es la más barata de escribir y la que más se omite.
7. Preguntas abiertas, cada una con cómo reducirla
¿Las variantes de producto van como filas separadas? Primero mirá cómo las muestra el sitio y proponé; por defecto, sí.
La razón por la que esta sección existe: el agente no marca su propia incertidumbre, la resuelve en silencio. Las incógnitas sin nombrar son el lugar exacto donde las corridas se descarrilan.
La disciplina de largo: menos de 800 palabras
Acá viene la restricción que sorprende. Una especificación más larga no es mejor: a más longitud, peor adherencia a todas sus reglas. Los modelos pierden consistencia alrededor de las 150 a 200 instrucciones en un prompt.
Las referencias del libro:
| Tipo de trabajo | Extensión | Alcance |
|---|---|---|
| One-shot | 100-300 palabras | Una tarea acotada, un agente, una corrida |
| Feature | 500-1.000 palabras (techo justificado en 800) | Varios entregables, días de trabajo |
| Iniciativa | 2.000-5.000 palabras | Semanas o meses, con un árbol de specs hijas abajo |
Y la regla de oro para no sobreingenierizar: si la especificación es más larga que el entregable esperado, sobra. Pero objetivo, criterios y límites nunca faltan.
Hay una cosa más que explícitamente no va en una spec: el stack obligatorio, la API prediseñada, el plan archivo por archivo. En palabras del libro: explícito en el qué, callado en el cómo. Decí cómo se ve el éxito y qué no se puede romper, y dejá que quien implemente proponga el plan. Cada detalle de implementación que prescribís le quita criterio a quien sabe más que vos sobre ese sitio.
Las specs que se pueden hacer trampa
Esta es la sección que más conviene leer dos veces si vas a contratar extracción de datos. El principio:
Todo criterio que se pueda cumplir sin resolver el problema, se va a cumplir así.
Ejemplos, en versión datos:
| Criterio tramposo | Cómo se cumple sin resolver nada | Versión que no se puede trampear |
|---|---|---|
| "el scraper corre sin errores" | Un | "extrae al menos 11.500 de los 12.000 productos del catálogo" |
| "los datos están completos" | Todos los campos presentes, la mitad con | "menos del 1% de nulos en SKU, precio, moneda y URL" |
| "la entrega es puntual" | Se entrega un archivo vacío a horario | "el archivo tiene conteo dentro del ±20% de la media de 7 días" |
| "performance aceptable" | Cualquier número cumple | "la corrida completa termina en menos de 90 minutos" |
Los otros antipatrones que lista el libro, con nombres muy reconocibles: la spec vaga disfrazada de técnica (vocabulario sofisticado que igual no decide nada: "mecanismo de reintento idempotente" sin decir backoff, máximo de intentos ni qué operaciones); la que esconde supuestos ("el manejo de errores estándar", "nuestras convenciones" — ¿cuáles, dónde?), que Osmani llama la más seductora porque el autor siente que comunicó algo y no comunicó nada; la que en realidad es una queja ("los datos que tenemos son un desastre, mejoralos"); y la vencida, que era correcta cuando se escribió y se sigue leyendo como verdad.
Sobre esa última hay una regla que conviene adoptar: nunca pongas a ejecutar una spec en la que ya no creés.
El paso que casi nadie da: pedir el plan antes de la ejecución
Kousen trae una idea clásica a este terreno: Design by Contract, de Bertrand Meyer. Aplicada, el contrato tiene postcondiciones (qué tiene que ser cierto al terminar), precondiciones, invariantes y criterios negativos (qué no tiene que pasar).
Y hace la observación que justifica todo el artículo:
Un agente que falla una postcondición no tira una excepción. Simplemente te dice que terminó.
Por eso el hábito de mayor rendimiento, según los dos libros, es pedir el plan escrito antes de que se escriba una línea de código, y revisarlo. Un buen plan repite los criterios, lista los pasos en orden, explicita supuestos y marca las preguntas abiertas.
Esa revisión separa dos fallas que se parecen y se arreglan distinto:
- si el plan malinterpreta una spec clara, el problema es la lectura;
- si la lee bien y lleva a algo que no querías, pediste lo incorrecto, y ninguna ejecución te salvaba.
Mejor todavía, y cuesta cinco minutos: pedile a quien va a implementar que critique la spec antes de empezar. ¿Qué ambigüedades ves? ¿Qué casos borde faltan? ¿Qué invariantes no están dichos? Osmani calcula que treinta minutos con la especificación suelen ahorrar una ronda entera de trabajo.
Un detalle más, y es de gestión: el contrato se congela cuando se aprueba. Cambiar la definición de terminado a mitad de la corrida es una negociación nueva, no un retoque silencioso. Un contrato que se mueve no es un contrato.
El bonus comercial: la misma spec te sirve para vender
Acá hay algo que el libro no dice y que para un proyecto de datos es casi gratis.
Una spec bien escrita, con un poco de pulido, es el anexo técnico de la propuesta comercial:
- los criterios de aceptación son el acuerdo de nivel de servicio;
- los invariantes son las garantías;
- el fuera de alcance es lo que no está incluido en el precio;
- la definición de terminado es el criterio de conformidad de la entrega.
Una sola pieza de trabajo te sirve para vender, para construir y para verificar. Es, probablemente, la media hora mejor invertida de todo el proyecto.
En Data Factory esta definición es el primer paso del proceso: se acuerdan los campos, la frecuencia, el formato y los criterios antes de escribir código. Si lo que necesitás es gente senior que escriba estas especificaciones adentro de tu equipo, eso es Data Squad.
Preguntas frecuentes
**¿Cuánto tiene que medir la especificación de un proyecto de datos?**Entre 300 y 500 palabras para un flujo de un sitio; hasta 800 para un proyecto con varias fuentes. Más largo no es mejor: la adherencia a las reglas baja con la longitud. Lo que no puede faltar nunca es objetivo, criterios chequeables y límites.
**¿Qué pasa si no sé todavía qué datos necesito exactamente?**Eso va en la sección de preguntas abiertas, con un valor por defecto para cada una. Es muy distinto a dejarlas sin escribir: una pregunta abierta con un valor por defecto es una decisión que podés revisar; una pregunta no escrita es una decisión que alguien va a tomar por vos sin decírtelo.
**¿Por qué no conviene especificar las herramientas y la implementación?**Porque cada detalle que prescribís le quita criterio a quien conoce el sitio mejor que vos, y si la receta está mal, el resultado es peor. La regla del libro es explícito en el qué, callado en el cómo: definí el resultado y las restricciones, y que el plan lo proponga quien implementa.
**¿Cómo evito criterios de aceptación que se puedan cumplir con trampa?**Poniendo números y ejemplos. "Sin errores" se cumple tragándose las excepciones; "al menos 11.500 registros con menos del 1% de nulos en los campos obligatorios" no. La prueba es preguntarte: ¿existe alguna forma de cumplir esto literalmente sin resolver mi problema? Si existe, reescribilo.
**¿Esta spec sirve también si contrato un proveedor en lugar de usar agentes?**Sirve más todavía. Un proveedor, igual que un agente, rellena los huecos que le dejás, solo que tarda más en hacerlo. Y además te queda convertida en el anexo técnico del contrato: criterios de aceptación como nivel de servicio y fuera de alcance como límite de lo contratado.
Para seguir leyendo
- Validación de datos extraídos: 7 chequeos antes de confiar
- Scraping con IA: generar es barato, verificar sigue caro
- Scraping gestionado frente a in-house con agentes
- El costo real del scraping con agentes de IA
- Pasos de la extracción de datos
- Tipos de extracción de datos
- Cómo elegir el proveedor de scraping adecuado
- Casos de uso de web scraping que impulsan negocios